Pipeline e Arquitetura Medalhão no Databricks
A cada dia que passa, mais empresas começam a usar o Databricks em suas plataformas de dados, mais oportunidades são criadas e a demanda por essa ferramenta só aumenta. A cada dia que passa, você pode estar ficando mais longe da tão sonhada vaga.
Neste workshop, você vai construir um projeto completo unindo Engenharia e Arquitetura de Dados, transformando os dados de vendas até a construção de um Data Warehouse com Arquitetura Medallion Raw - Journal - Purpose.
Na prática, serão utilizados Python, PySpark, SQL e Databricks para construir um pipeline de dados e uma arquitetura completa, organizando dados de forma eficiente e escalável.
Usaremos as principais ferramentas do Databricks para termos uma solução totalmente escalável e controlada com foco na governança.


O workshop começa em
O que você vai dominar
As ferramentas usadas no mercado para construir pipelines de dados de ponta a ponta.
Arquitetura Medalhão
O padrão adotado por Databricks, Airbnb e Netflix – implementado sobre dados reais de vendas.
Ingestão bruta dos dados de vendas – pedidos, clientes, SKUs, datas. Dados sem transformação, exatamente como vieram da fonte.
Limpeza e padronização de dados. Remoção de duplicatas, normalização de datas e join de dimensões estruturais.
Aplicação das regras de negócio e consolidação das tabelas analíticas para consumo: dashboards e relatórios de vendas por região, produto e período.
O que acontece no dia
7 de novembro, das 09h00, ao vivo – do problema de negócio ao pipeline funcionando.
Quem faz parte do Dados Por Todos
Veja o que algumas pessoas da comunidade têm a dizer sobre fazer parte do DPT.
Tenho gostado bastante dos conteúdos da comunidade, acho bem didáticos e acessíveis para quem está ingressando na área. Inclusive, consegui minha oportunidade de analista de dados Jr com projetos e conhecimentos que adquiri pela comunidade.
Fiz uma transição de carreira do serviço público, onde passei 12 anos, para desenvolvedor Python na área de dados. Nesse caminho, o Dados Por Todos virou uma das minhas principais fontes de aprendizado. As indicações que circulam na comunidade são sempre muito certeiras e me poupam tempo, porque aponto o estudo para o que realmente vale a pena. Recomendo para quem está começando ou migrando de área.
A minha experiência tem sido bem satisfatória, pois além da comunidade ser ativa, qualquer dúvida que eu tenha eles são muito receptivos em me responder. Além disso, o clube do livro é uma oportunidade de solidificar conhecimentos e trocar ideias.
Tem sido bom, sempre que estou precisando de uma dica, é só perguntar que várias pessoas vão me ajudando, e me ajudou muito a ver um rumo para seguir. Por mais que não tenha um passo a passo do que estudar, pelo menos sei quais ferramentas tenho que aprender.
Vocês fazem muita diferença pra quem é da área ou quer começar. Esse ambiente é valioso demais, e o pessoal é gente finíssima.
O Dados por Todos tem bastante potencial de crescimento, inclusive pra quem está iniciando. Vejo um ajudando o outro com a experiência que eles já têm. Que a comunidade continue progredindo do jeito que está.
Seu instrutor
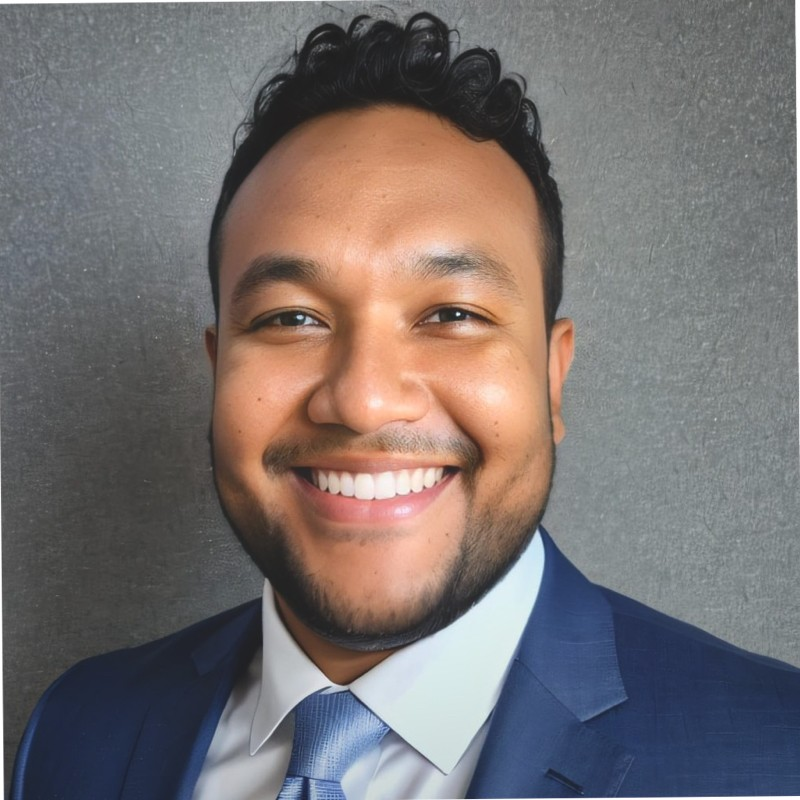
Matheus Zanforlin, 27 anos, é Senior Data Engineer e atua na área de dados desde os 16 anos, quando iniciou sua trajetória com a criação de dashboards.
Ao longo da carreira, desenvolveu experiência em projetos end-to-end de dados, com atuação na construção de Data Warehouses e Data Lakes em AWS, GCP e Azure, além do desenvolvimento de pipelines ETL utilizando dbt-Core e Airflow.
Também possui experiência na estruturação de dados e criação de KPIs para diferentes áreas de negócio, incluindo Facilities, Hospitais, Food Service, Marketing e Vendas.
Seu repertório técnico inclui Python, SQL, Power BI, Looker e Tableau, além de fluência em inglês e espanhol. Com perfil analítico e organizado, possui experiência em diferentes contextos de negócio e facilidade para trabalhar com novas tecnologias.
Fundadores do Dados Por Todos
Conheça quem está construindo esse ecossistema para democratizar o acesso à área de dados.
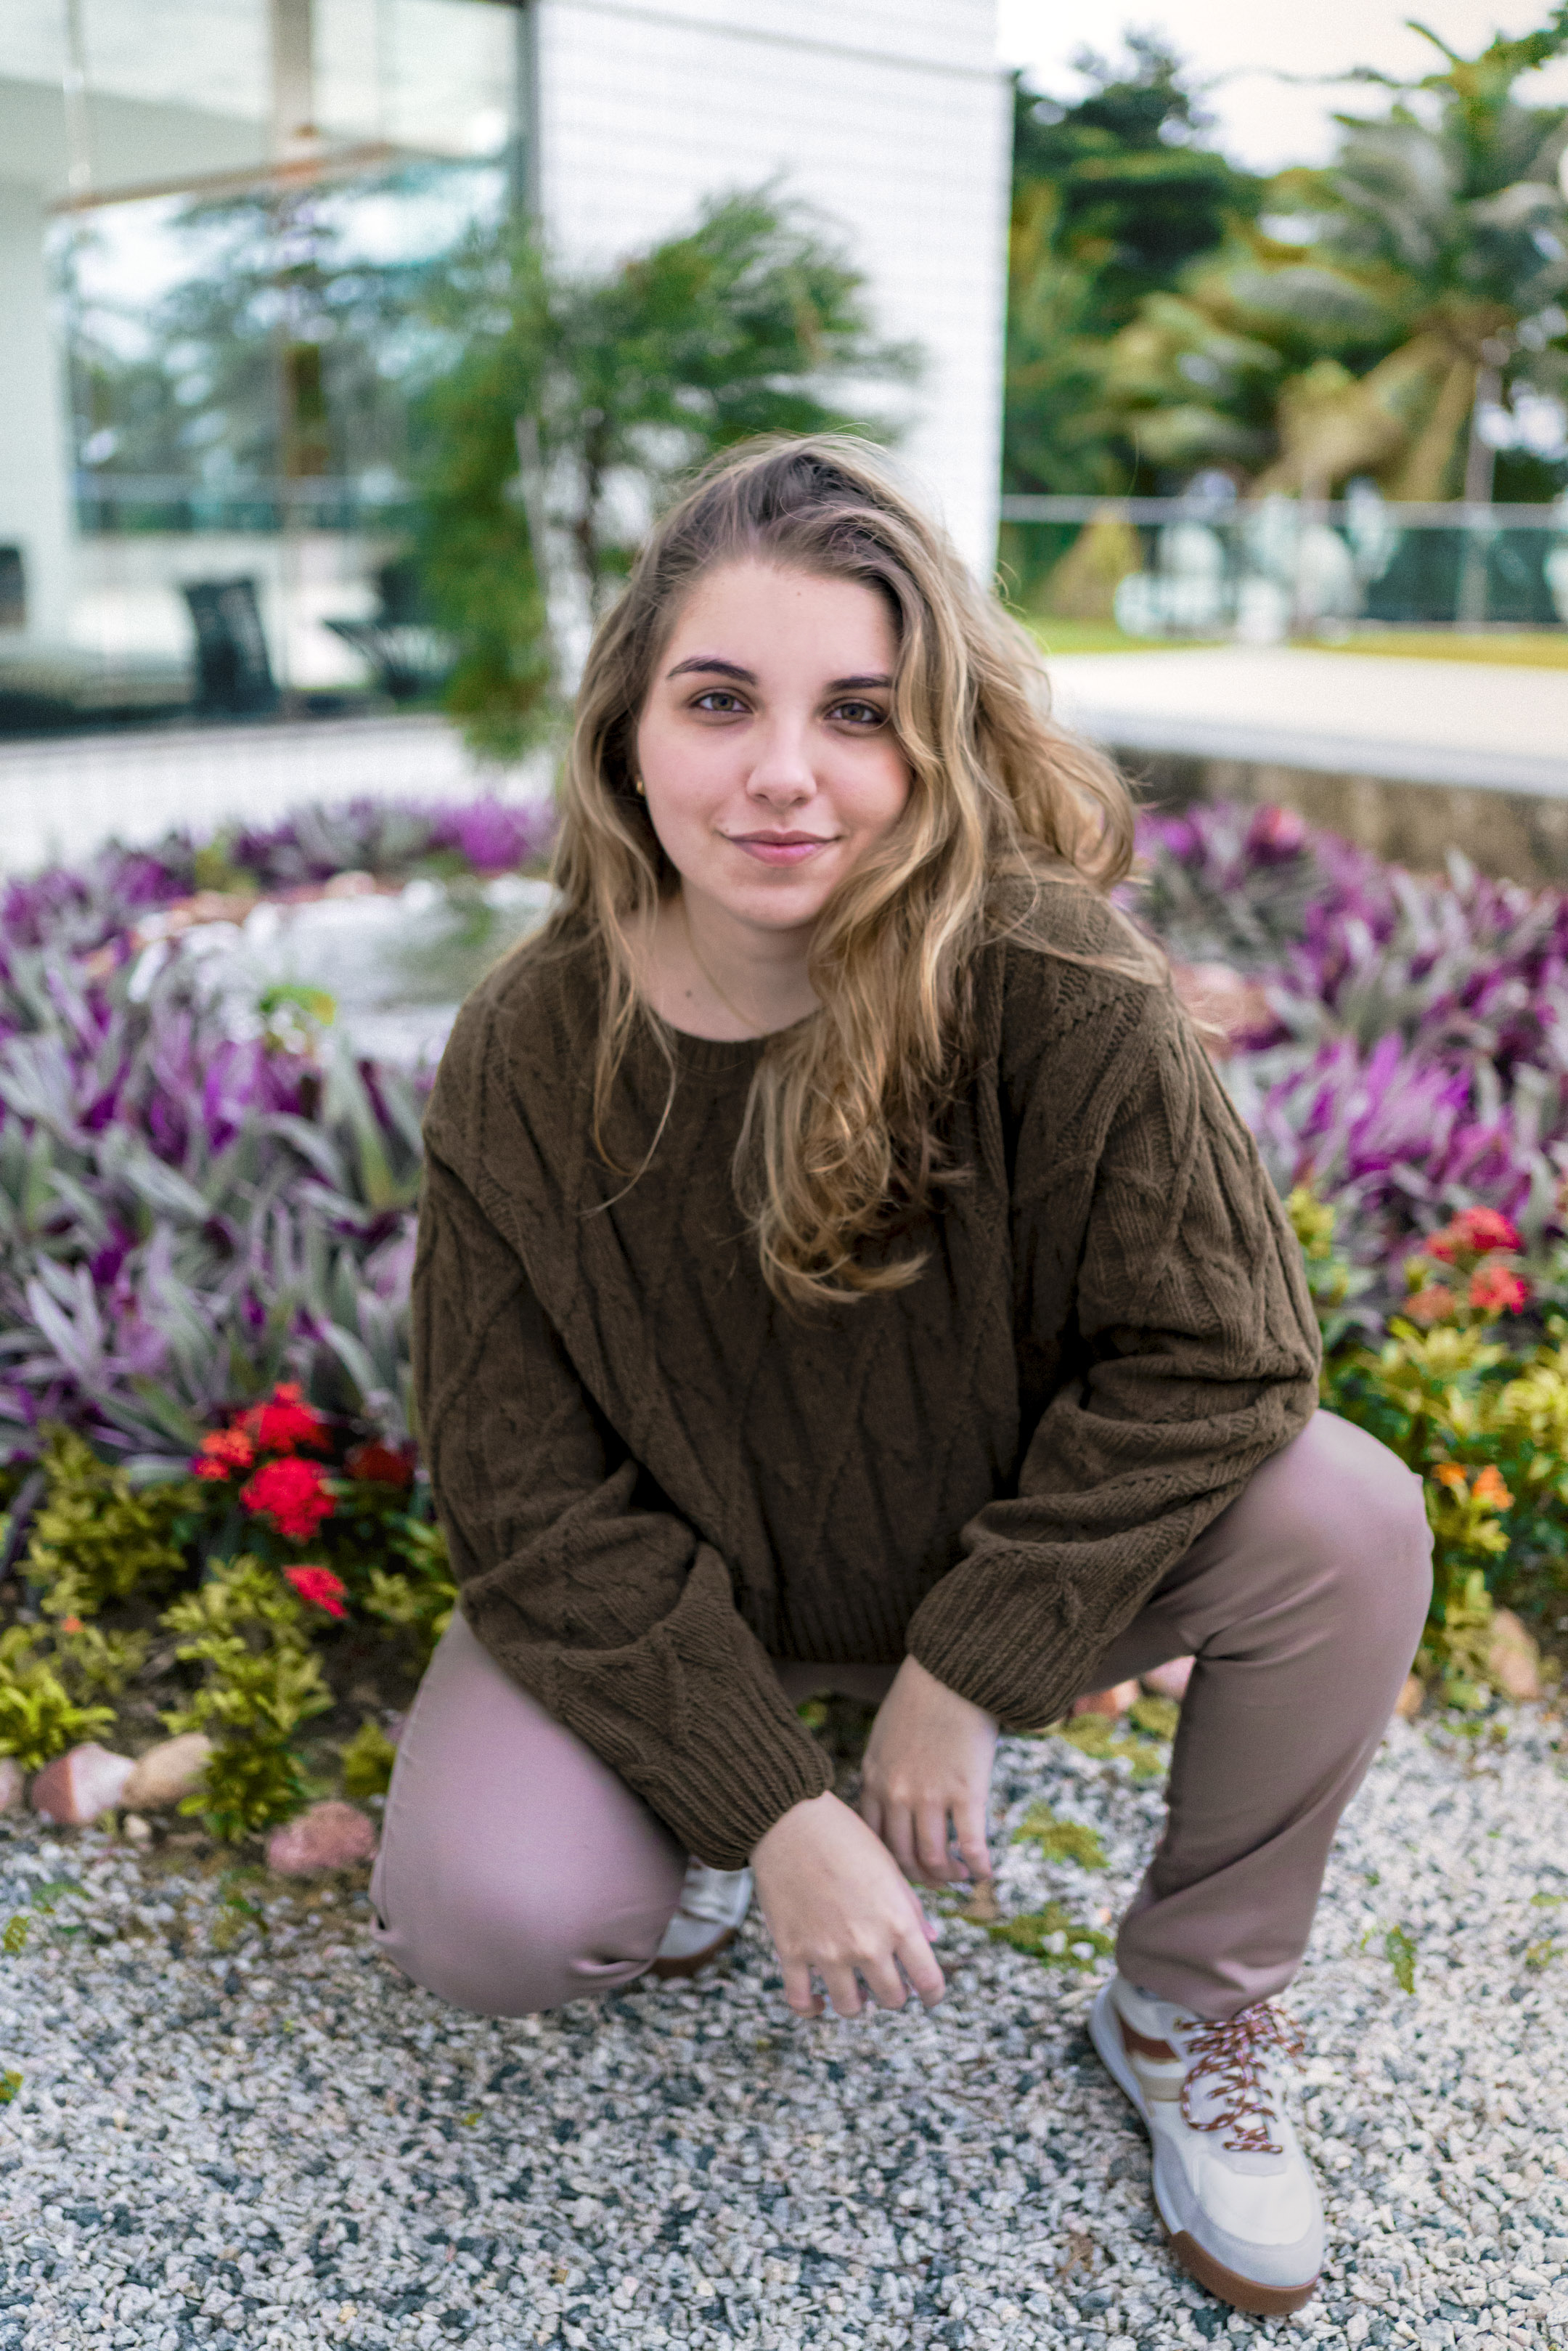
Engenheira de Dados, professora na Jornada de Dados e criadora de conteúdo educacional, responsável pelas trilhas de Python e Pandas. Fundadora do Dados Por Todos e criadora de conteúdo sobre Engenharia de Dados, programação e tecnologia, com mais de 140 mil inscritos no YouTube.
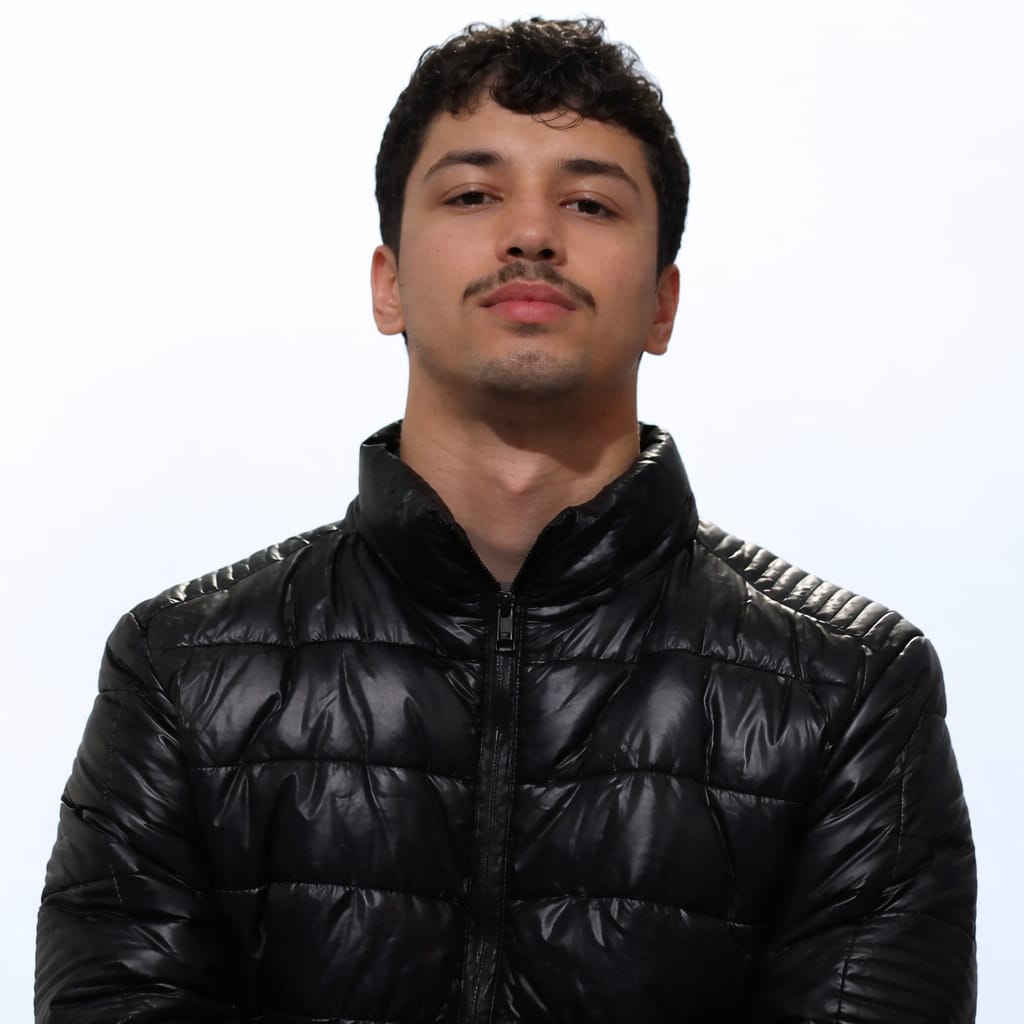
Engenheiro de Dados Júnior no Dados Por Todos, desenvolvendo soluções e projetos de tecnologia. Apaixonado por programação e por transformar dados em decisões e produtos úteis. Atuo na criação de ferramentas e iniciativas que aproximam tecnologia e educação, com projetos que já alcançaram milhares de pessoas.
Perguntas frequentes
Preciso ter conhecimento prévio em programação?
Para este workshop, é recomendado ter uma base lógica, mas explicaremos cada etapa do pipeline passo a passo.
Como funciona o acompanhamento?
Teremos suporte ao vivo durante o workshop e grupo exclusivo para tirar dúvidas.
Quando começa?
O workshop ao vivo será no dia 7 de novembro às 09h00 (horário de Brasília).
Recebo certificado?
Sim, ao concluir o workshop você receberá um certificado de participação.
Vai ter gravação salva?
Sim! O workshop vai ficar gravado e disponível na nossa plataforma na Hotmart.
Preciso instalar algo no meu computador?
Não! Vamos utilizar o Databricks Free Edition, que roda direto no seu navegador.